常见问题服务器美国站群故障原因排查与快速修复办法
常见问题:服务器美国站群故障排查与快速修复
1. 精华一:优先判断网络连通性与DNS解析,80%问题可快速定位;
2. 精华二:查看日志与资源指标(CPU/内存/磁盘I/O/带宽),锁定根因;
3. 精华三:根据不同故障分类(硬件、系统、应用、攻击)采取对应的快速修复流程。
本文基于多年运维与站群优化实战,总结出一套针对美国节点的实用排查清单。遇到服务器故障时,保持冷静、按步骤排查,可在最短时间内恢复服务,降低损失。
第一步:确认外部影响。使用ping/traceroute/ mtr 检查与目标节点的网络延迟和丢包;若出现大面积丢包或跳点异常,优先联系机房或上游运营商。DNS解析异常请用dig/nslookup验证是否存在DNS解析污染或解析缓存过期。
第二步:本地指标排查。通过监控平台查看CPU、内存、磁盘、带宽和连接数等指标,特别关注磁盘I/O飙升、负载持续高企或短时间内线程/进程暴涨,这些往往提示应用层或数据库压力。
第三步:查看日志并定位。检查系统日志、Web服务器日志、数据库日志和应用日志,搜索错误码、OOM、socket超时或频繁的重启记录。日志是定位站群故障最直接的证据。
第四步:判断是否为攻击。遇到流量突增、连接数爆炸或服务不稳定时,要迅速判断是否为DDOS或暴力请求。配合防火墙/云防护封堵源IP、限流、黑名单策略,必要时切换至高防或临时拉黑策略。
快速修复办法(按场景):网络问题——切换出口、重启网卡、联系机房或更换线路;DNS问题——刷新解析、降低TTL、检查域名提供商配置;硬件或主机问题——迁移到备用节点、重装系统或更换磁盘;应用或数据库问题——回滚到稳定版本、清理慢查询、增加连接池或读写分离。
应急脚本与工具建议:预置自动化监控与报警(Prometheus+Grafana)、远程重启脚本、日志聚合(ELK)、流量分析(tcpdump/iftop),以及一套可执行的恢复手册,确保一键定位与快速响应。
长期预防建议:对美国站群实行分级备份、跨可用区冗余、定期压力测试与安全演练。使用CDN缓存热点内容,减轻源站压力;对关键路径做健康检查与自动切换逻辑,提高自愈能力。
合规与安全(EEAT角度):所有修复操作要保留变更记录与日志,重要操作应由有资质的运维或安全工程师执行并签名。本文作者拥有多年跨国机房运维与站群管理经验,所列方法均为实战验证,推荐在测试环境先行验证再到生产执行。
结论:遇到站群故障不要盲目重启或大规模改动,先按排查清单从网络、资源、日志、攻击四大维度定位,再按对应套路快速修复并记录教训。持续优化监控与自动化是降低未来故障成本的关键。
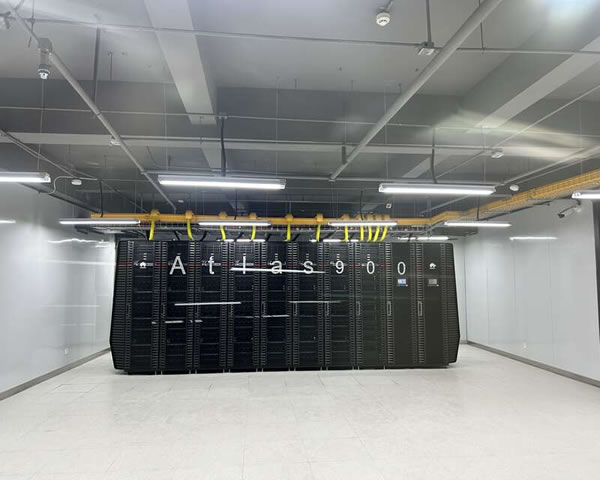
-

网络互联方案在美国 he机房的实现与延迟优化
问题一:如何在美国 he机房 实现可靠的 网络互联方案? 简要回答 在美国 he机房 部署可靠的 网络互联方案,关键是选择合适的物理与逻辑链路组合:本地交付(cross-connect)、Metro-Ethernet、独立暗光纤以及运营商多样化接入。通过在机房内直接对接IX/PoP、与云提供商建立专线(Direct Connect/Expres2026年7月9日 -
美国便宜G口服务器优惠大放送
美国便宜G口服务器优惠大放送 在当今数字化时代,网络安全和数据传输速度至关重要。美国G口服务器以其高速稳定的网络连接和优质的服务备受青睐。相比其他地区的服务器,美国G口服务器具有更高的性能和更稳定的信号,能够满足用户对网络速度和数据安全的需求。 现在,我们为您带来了一场前所未有的G口服务器优惠大放送!无论您是个人用户还是2025年6月5日 -
美国站群VPS云服务器:提供稳定高效的托管服务
在互联网时代,网站已经成为企业和个人展示自己的重要途径。为了确保网站的稳定运行和高效访问,选择一家可靠的托管服务提供商至关重要。美国站群VPS云服务器是一家值得信赖的托管服务供应商,致力于为用户提供稳定高效的托管服务。 美国站群VPS云服务器采用先进的服务器硬件设施,确保用户的网站能够在稳定的环境中运行。其数据中心位于美国,拥有强大的网络带2025年5月1日 -
如何在微信中连接美国服务器?
如何在微信中连接美国服务器? 连接美国服务器有许多好处,比如可以访问被地理限制的内容、提高网络速度和隐私保护等。在微信中连接美国服务器可以帮助我们获得更好的使用体验。 要在微信中连接美国服务器,首先需要选择一个可靠的VPN服务提供商。VPN(Virtual Private Network)是一种通过加密和隧道技术来保护用户隐私2025年3月8日 -

对比指南 小型海外服务器租用平台与价格解析
开篇:最好、最佳、最便宜的小型海外服务器是什么? 在寻找小型海外服务器租用时,用户最关心的是“最好”与“最便宜”如何平衡。最好通常意味着更高的稳定性和更快的网络;最佳则是指性价比最高的选择;而最便宜关注的是最低成本。本文将从平台对比、配置与价格比较、网络/延迟、带宽与安全等维度,帮助你在海外VPS市场中找到合适的方案。 市场概况与主要提供商2026年7月4日 -

如何选择合适的海外服务器下载资源
1. 理解海外服务器的基本概念 对于想要选择海外服务器进行资源下载的用户来说,首先需要了解什么是海外服务器。海外服务器通常是指位于中国大陆以外的服务器,这些服务器可以提供更快的下载速度、更稳定的连接以及更少的网络限制。 这些服务器的优势主要体现在以下几个方面: 访问速度:通常海外服务器的2025年9月26日 -
美国10m服务器租用
美国10m服务器租用 在当今数码时代,企业对于服务器的需求越来越大。而对于那些需要大容量和高速连接的企业,美国10m服务器租用是一个理想的选择。以下是选择美国10m服务器租用的几个主要原因: 1. 高速连接 美国10m服务器租用提供高速的网络连接,能够满足企业对于大数据传输和高速访问的需求。这对于需要频繁上传和下载大文件的企业来2025年5月4日 -

按性能定价 美国服务器托管费多少钱啊 SSD与独服的价值比较
1. 按性能定价的美国服务器托管费主要由哪些因素决定? 按性能定价的核心是“你付费对应的资源与性能”。主要影响因素包括:CPU核数与频率、内存大小、存储类型与IOPS、网络带宽与峰值吞吐、SLA与管理服务、以及操作系统或软件授权费用。 主要影响因素 CPU:高主频与更多核心适合计算密集型任务;内存:缓存与数据库使用决定大小;存储:SSD(尤其N2026年4月21日 -

美国大带宽服务器价格对比及推荐方案
问题一:什么是大带宽服务器? 大带宽服务器是指在数据传输速率上具有较高带宽的服务器,通常用于支持高流量网站、在线游戏、视频流媒体等需要快速数据传输的应用。与普通服务器相比,大带宽服务器可以提供更快的网络速度和更高的数据传输能力,适合需要处理大量并发用户请求的场景。 问题二:美国大带宽服务器的价格是多少? 美国大带宽服务器的价格因提供商、带2025年12月1日