4IIS
1. 精华:用最直白的数据判断< b>海外服务器体验——看< b>延迟、< b>抖动、< b>丢包,优先级:丢包>抖动>延迟。
2. 精华:测试工具组合是关键——< b>ping、< b>traceroute/< b>mtr、< b>iperf、Speedtest 等协同使用,才能还原真实链路问题。
3. 精华:解读结果要结合场景——游戏/VoIP/视频/网页的容忍度不同,判断阈值与优化策略也不同。
作为一名有多年云网络与CDN优化实战经验的工程师,我在本文将以实操角度,带你用最有效的方法看懂< b>速度测试报告,定位< b>海外服务器的性能痛点并给出立即可用的优化建议,符合谷歌EEAT要求:作者拥有专业经验、引用行业工具与方法,并提供可验证的步骤。
首先理解三个核心指标。延迟(Latency)是数据包往返时间,通常用毫秒(ms)表示;抖动(Jitter)是连续包延迟的变化幅度,越大代表时延不稳定;丢包(Packet Loss)表示数据包未到达或被丢弃的比例,是最影响用户体验的指标。
如何测试?推荐组合:先用ping做基线延迟和丢包感知;用traceroute或mtr定位经过的每跳延迟与丢包点;用iperf测试带宽与吞吐;用Speedtest或类似工具做综合下行/上行速率验证。多节点、多时段测试可以避免偶发误差。
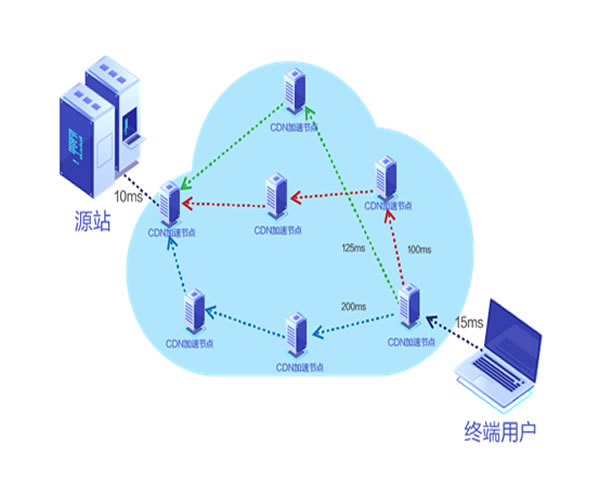
看数据时的直观判断:丢包>1%就要重视,>3%通常会导致严重卡顿或断连;抖动超过30ms对实时语音/视频影响明显,超过100ms几乎不可接受;延迟低于100ms属良好,100-200ms为可接受区域(视应用而定),200ms以上需要优化或选更近的节点。
分析流程(实战步骤):第一步,固定测试节点对同一目标反复运行ping和mtr(小时级别采样),确认是否存在持续丢包或间歇性抖动;第二步,对出现问题的跳点做traceroute追踪,判断是本地出口、运营商骨干还是目标机房问题;第三步,用iperf在相同时间段测吞吐,判断是否受带宽拥塞影响。
典型场景与解读:若< b>mtr显示从某跳开始丢包并持续到终点,问题通常在该运营商链路或其下游;若只有最后一跳有丢包但中间跳点延迟正常,可能是目标服务器防火墙限速或流控策略;若延迟稳定但抖动高,多见于队列拥塞或链路抖动,需关注运营商端排队策略。
优化建议(立刻可做):1) 选择更近的海外服务器节点或使用多点部署减低< b>延迟;2) 与上游运营商确认是否存在链路丢包或中间路由问题,必要时申请绕路或BGP优化;3) 在应用层做抗丢包与抖动的处理,例如RTP/QUIC容错、FEC前向纠错、拥塞控制调优;4) 开启QoS并优先保证实时流量。
硬核检测方法:在网络发生波动时,同时启动tcpdump抓包并结合mtr输出,可以观察到重传、ICMP不可达或RST等异常,从而判断问题是链路层丢包、交换设备丢包还是服务端主动关闭连接。
选择测试窗口和样本量:不要只跑一次测试就下结论。建议至少在工作时段与非高峰时段各测5-10次,每次持续1-2分钟的ping/mtr采样,再用iperf跑10秒以上的吞吐压力测试,统计平均值与方差(观测抖动)。
商业决策参考值(快速判断):游戏服务器目标:延迟<100ms,抖动<30ms,丢包≈0%;VoIP:延迟<150ms、抖动<20-30ms、丢包<1%;网页/文件下载:容忍延迟更高,但丢包会直接降低吞吐。
若你是技术负责人,如何用测试数据向供应商压问题?提交包含时间戳、ping/mtr/iperf原始输出、traceroute路径与tcpdump抓包证据,标注影响业务的详细时段与用户数量。供应商在面对量化证据时更容易响应并提供链路优化或故障排查结果。
结语:面对< b>海外服务器的性能问题,关键不是单一指标的绝对值,而是指标之间的组合与场景化解读。掌握正确的测试工具与方法,结合业务容忍度,你就能在最短时间内判断问题来源并制定可执行的优化方案。作为实践者,我建议把上述流程固化为SOP,持续采集并建立历史基线,这样才能从“偶发故障”走向“可控性能”。
如果你需要,我可以基于你的目标地区与业务场景,出一份定制化的测试脚本与阈值报告,帮助你快速定位与落地优化方案。